Cada día la web se enriquece con una enorme cantidad de nuevos dominios, páginas y contenidos. Si gestionas la seguridad informática para una empresa, un ISP o un MSP, el reto es inmediato: ¿cómo aplicar una política de navegación a un dominio que el sistema aún no conoce? Aquí es donde entra en juego la AI Domain Classification de FlashStart.
Al determinar la categoría de un nuevo contenido, las palabras clave pueden proporcionar una primera señal, pero rara vez son suficientes para distinguir el contexto: un artículo divulgativo sobre el juego de azar y un portal de apuestas activo comparten a menudo gran parte del vocabulario, a pesar de tener propósitos completamente opuestos.
La clasificación contextual supera este límite analizando las relaciones entre las palabras presentes en la página, en lugar de limitarse a su mera aparición. Este es el enfoque adoptado por FlashStart gracias a la implementación de DeBERTa-v3-base, un modelo neuronal ajustado mediante fine-tuning para lograr una alta precisión y exactitud semántica.
La arquitectura de la pipeline de IA de FlashStart: del dominio web a la inferencia contextual
El sistema analiza los dominios desconocidos a través de una pipeline modular compuesta por un control preliminar de pre-crawling y tres fases sucesivas de procesamiento de IA. Cada fase tiene una responsabilidad precisa, asegurando que la clasificación final siempre pueda rastrearse hasta el contenido de origen:
- Pre-crawling: aplica puertas de decisión (decision gates) configuradas antes de iniciar cualquier procesamiento de IA.
- Crawl: recupera el contenido renderizado del dominio y extrae el texto más representativo.
- Preprocessing: elimina el contenido no apto para la inferencia, normaliza el texto extraído y lo traduce al inglés.
- Classification: envía el texto preparado al modelo DeBERTa-v3-base y genera predicciones ordenadas por categoría.
Este flujo de trabajo ágil y escalable permite a los sistemas de políticas de FlashStart analizar y clasificar los nuevos dominios on-the-fly en pocos segundos, conservando todos los datos relevantes para análisis e informes.
Pre-crawling decision gates: filtros basados en reglas rápidos y deterministas
Antes de que un dominio ingrese en la pipeline de IA, el mecanismo de pre-crawling evalúa decision gates específicos. Un gate puede clasificar un dominio al instante, excluirlo del procesamiento o permitirle continuar hacia la fase de rastreo (crawling). De este modo se obtienen decisiones inmediatas y de alta confianza para casos conocidos, preservando recursos de cómputo y evitando latencias.
La implementación actual incluye un gate dedicado a known-TLDs: una regla “fast-track” que clasifica el sitio web basándose exclusivamente en su extensión de dominio, garantizando rapidez y precisión. Los dominios que no coinciden con un gate preconfigurado avanzan automáticamente a las siguientes fases de la pipeline, garantizando una arquitectura flexible y pensada para una evolución continua.

Protección DNS de última generación, totalmente basada en la nube y en la inteligencia artificial, y fácil de activar.
Crawling dirigido: construir una representación textual precisa de la página
El crawler abre la URL solicitada dentro de una sesión de navegador aislada (browser context). Esto permite capturar y procesar incluso el contenido dinámico generado mediante JavaScript en el lado del cliente, tal como lo haría un navegador real, siguiendo posibles redirecciones pero manteniéndose rigurosamente enfocado en el sitio web de destino.
En lugar de consumir ancho de banda descargando archivos multimedia pesados, rastreadores publicitarios o scripts secundarios, el crawler de FlashStart extrae estratégicamente las señales esenciales que mejor definen el significado y la actividad del sitio mediante:
- Metadatos de la página: título, meta description y encabezados principales que proporcionan un indicador temático inmediato.
- Contenido del cuerpo principal: texto contextual que permite a la IA captar matices indispensables para distinguir páginas con títulos genéricos o similares.
El crawler almacena el texto extraído y limpio, el estado de la respuesta HTTP, la URL final y el contenido renderizado para garantizar una trazabilidad total. Mecanismos inteligentes de control de calidad identifican oportunamente los eventos no vinculados al contenido, registrándolos como estados operativos en lugar de forzar categorizaciones artificiales.
Además, el texto extraído se normaliza y se limita a un número limitado de letras, descartando previamente menús de navegación repetitivos antes de pasar al tokenizer del modelo.
Preprocesamiento del texto: normalización y coherencia multilingüe
La fase de preprocesamiento transforma la salida sin procesar del crawler en una entrada estandarizada y optimizada para el modelo de deep learning. De esta manera, FlashStart aísla el significado semántico auténtico de cada sitio web.
Durante la extracción, los espacios se uniforman y se eliminan las cadenas de URL. Esta precaución garantiza que el clasificador aprenda del texto real de la página y no de indicios superficiales como parámetros de seguimiento UTM, rutas de red o direcciones CDN.
A continuación, el texto normalizado se traduce al inglés, almacenando en los metadatos el idioma original detectado. Esta estandarización lingüística permite que el modelo de deep learning opere con una precisión alta y uniforme en dominios internacionales en cualquier idioma. Conservar tanto el texto original como la traducción al inglés garantiza una total auditabilidad durante las actividades de cumplimiento y revisión.
Esta fase también actúa como un auténtico “quality gate”: el contenido debe cumplir con criterios precisos de exhaustividad y legibilidad antes de acceder a la inferencia, asegurando que la IA procese únicamente datos sólidos y representativos.
Protección DNS de última generación, totalmente basada en la nube y en la inteligencia artificial, y fácil de activar.
Clasificación contextual de secuencias con DeBERTa-v3-base
Para la fase de clasificación FlashStart recurre a DeBERTa-v3-base. En comparación con las arquitecturas transformer tradicionales, DeBERTa adopta un mecanismo de atención desacoplada (disentangled attention) que evalúa por separado el contenido léxico y la posición relativa de las palabras, capturando con extrema precisión las dependencias sintácticas y semánticas de la secuencia. Esta comprensión contextual permite discriminar matices complejos, distinguiendo, por ejemplo, un artículo divulgativo sobre ciberseguridad de una amenaza activa de phishing.
Antes de la inferencia, el texto se tokeniza y se trunca a la longitud de contexto admitida de forma nativa por el modelo. A continuación, el algoritmo calcula las puntuaciones de probabilidad distribuyéndolas entre las 18 categorías de la taxonomía de seguridad de FlashStart.
Cada procesamiento devuelve una inteligencia de dominio estructurada:
- Top Category: la categoría principal con la puntuación de relevancia más alta.
- Confidence Score: un valor de confianza relativo que refleja el nivel de certeza del modelo para la categoría principal.
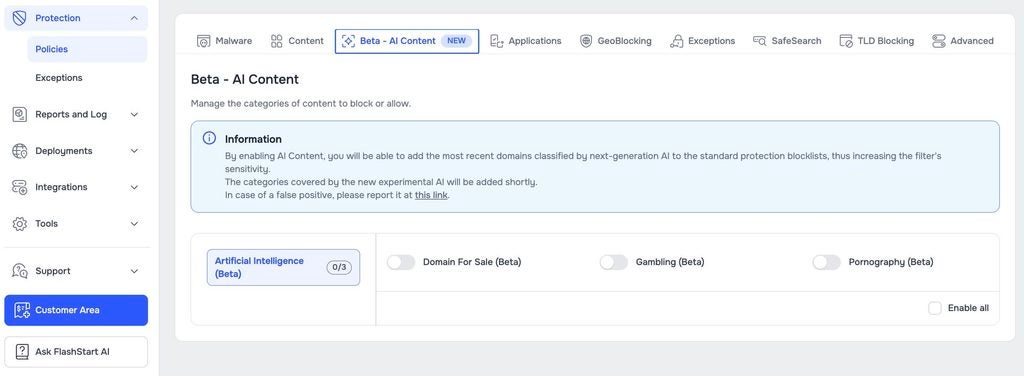
- Ranked Predictions: las tres categorías actualmente soportadas son domainforsale, gambling, pornography, permitiendo a los sistemas posteriores evaluar oportunamente posibles casos de ambigüedad.
- Inference Provenance: referencias de trazabilidad que vinculan la clasificación final con el resultado del rastreo, el texto traducido y la marca de tiempo exacta.
Inteligencia operativa e innovación continua
FlashStart mantiene una separación nítida entre la clasificación de la IA y la aplicación de las políticas: la IA proporciona una rica inteligencia sobre los dominios, mientras tú mantienes el control total sobre las reglas de filtrado DNS aplicadas a tu red.
Para preservar la precisión a lo largo del tiempo frente a la evolución de las amenazas web, FlashStart optimiza constantemente sus modelos de IA mediante telemetría real, conjuntos de validación representativos y procesos de aprendizaje activo.
¿Quieres reforzar la seguridad DNS de tu organización? Prueba ahora la nueva funcionalidad de AI Domain Classification en el panel de control de FlashStart e integra una protección proactiva contra las amenazas de nueva generación. Para profundizar en los detalles de configuración e integración, consulta nuestra documentación oficial.
Protección DNS de última generación, totalmente basada en la nube y en la inteligencia artificial, y fácil de activar.
Preguntas Frecuentes (FAQ)
¿Cuál es el resultado final del servicio AI Domain Classification de FlashStart?
El valor fundamental del servicio reside en incrementar la sensibilidad y la reactividad de la protección DNS: gracias a la IA de nueva generación, los dominios recién registrados o previamente desconocidos se analizan oportunamente y se clasifican en las tres categorías compatibles actualmente: Domain For Sale, Gambling y Pornography, lo que permite al sistema integrarlos directamente en las listas de bloqueo estándar. Al mismo tiempo, el sistema genera una inteligencia de dominio estructurada (categoría principal, puntuación de confianza, predicciones alternativas ordenadas y resultado del rastreo) para garantizarte plena visibilidad, control y cumplimiento en los flujos de políticas e informes.
¿Esta funcionalidad de IA aplica directamente el bloqueo a nivel de DNS?
No. El componente de IA se encarga exclusivamente de generar inteligencia sobre el dominio, mientras que el motor de políticas de FlashStart aplica las reglas de filtrado, los umbrales de confianza y los permisos configurados. La funcionalidad se puede habilitar a discreción del administrador.
¿El crawler realiza un rastreo completo de todas las páginas del sitio?
No. El crawler se limita a obtener la página de la URL específica solicitada, siguiendo las redirecciones legítimas. No navega por enlaces externos ni por páginas secundarias, manteniendo el análisis extremadamente rápido, eficiente y con un bajo consumo de recursos, ahorrando ancho de banda.
¿Cómo gestiona el sistema los dominios inaccesibles o las páginas vacías?
Si un dominio no responde (por ejemplo, debido al tiempo de espera del servidor), la pipeline registra el evento como un resultado operativo de rastreo en lugar de asignar una categoría forzada. Esto preserva la integridad del modelo y reduce falsos positivos en dominios inactivos o estacionados.