Ogni giorno il web si arricchisce di un’enorme quantità di nuovi domini, pagine e contenuti. Se gestisci la sicurezza informatica per un’azienda, un ISP o per un MSP, la sfida è immediata: come applicare una policy di navigazione a un dominio che il sistema non conosce ancora? È qui che entra in gioco l’AI Domain Classification di FlashStart.
Nel determinare la categoria di un nuovo contenuto, le keyword possono fornire un primo segnale, ma raramente sono sufficienti a distinguere il contesto: un articolo divulgativo sul gioco d’azzardo e un portale di betting attivo condividono spesso parte del vocabolario, pur avendo finalità completamente opposte.
La classificazione contestuale supera questo limite analizzando le relazioni tra le parole presenti nella pagina, anziché limitarsi alla loro semplice occorrenza. È l’approccio adottato da FlashStart grazie all’implementazione di DeBERTa-v3-base, modello neurale sottoposto a fine-tuning per raggiungere elevata precisione e accuratezza semantica.
L’architettura della pipeline AI di FlashStart: dal dominio web all’inferenza contestuale
Il sistema analizza i domini sconosciuti attraverso una pipeline modulare composta da un controllo preliminare di pre-crawling e da tre fasi successive di elaborazione AI. Ciascuna fase ha una responsabilità precisa, assicurando che la classificazione finale possa sempre essere ricondotta al contenuto di origine. La pipeline si articola in:
- Pre-crawling: implementazione di un decision gate configurato prima dell’avvio dell’elaborazione AI.
- Crawl: recupero dell contenuto renderizzato del dominio ed estrazione del testo più rappresentativo.
- Preprocessing: rimozione del contenuto non idoneo all’inferenza, normalizzazione del testo estratto e traduzione in lingua inglese.
- Classification: input del testo preparato al modello DeBERTa-v3-base e generazione delle previsioni catalogate per categoria.
Questo flusso di lavoro snello e scalabile consente ai sistemi di policy di FlashStart di analizzare e classificare i nuovi domini on-the-fly in pochi secondi, conservando tutti i dati rilevanti per analisi e reportistica.
Pre-crawling decision gates: filtri rule-based rapidi e deterministici
Prima che un dominio entri nella pipeline AI, il meccanismo di pre-crawling valuta specifici decision gate. Un gate può classificare un dominio all’istante, escluderlo dall’elaborazione oppure lasciarlo proseguire verso la fase di crawling. In questo modo si ottengono decisioni immediate e ad alta confidenza per casistiche note, preservando risorse di calcolo ed evitando latenze. L’attuale implementazione include un known-TLD gate: una regola “fast-track” che classifica il sito web basandosi esclusivamente sulla sua estensione di dominio, garantendo rapidità e accuratezza. I domini che non corrispondono a un gate preconfigurato avanzano automaticamente alle fasi successive della pipeline, garantendo un’architettura flessibile e pensata per un’evoluzione continua.

Protezione DNS di nuova generazione, interamente basata sul cloud e sull'intelligenza artificiale, facile da attivare.
Crawling mirato: costruire una rappresentazione testuale accurata della pagina
Il crawler apre l’URL richiesto all’interno di una sessione browser isolata (browser context). Ciò consente di catturare ed elaborare anche i contenuti dinamici generati via JavaScript lato client, proprio come farebbe un browser reale, seguendo eventuali redirect ma restando rigorosamente focalizzato sul sito web di destinazione.
Anziché consumare banda scaricando pesanti file multimediali, tracker pubblicitari o script secondari, il crawler di FlashStart estrae strategicamente i segnali essenziali che meglio definiscono il contenuto e l’attività del sito tramite:
- Metadati della pagina: titolo, meta description e intestazioni principali che forniscono un indicatore tematico immediato.
- Contenuto del corpo principale: testo contestuale che permette all’AI di cogliere sfumature indispensabili per distinguere pagine con titoli generici o simili.
Il crawler archivia il testo estratto e pulito, lo stato della risposta HTTP, l’URL finale e il contenuto renderizzato per garantire la massima tracciabilità. Meccanismi intelligenti di controllo qualità identificano tempestivamente gli eventi non legati al contenuto, registrandoli come stati operativi anziché forzare categorizzazioni artificiali.
Inoltre, il testo estratto viene normalizzato e circoscritto ad un numero limitato di caratteri, scartando a monte menu di navigazione ripetitivi ed eventuali disclaimer superflui prima del passaggio al tokenizer del modello.
Preprocessing del contenuto: normalizzazione e coerenza multilingue
La fase di preprocessing trasforma l’output grezzo del crawler in un input standardizzato e ottimizzato per il modello di deep learning. In tal modo FlashStart isola l’autentico significato semantico di ciascun nuovo dominio web.
Durante l’estrazione, gli spazi vengono uniformati e le stringhe URL vengono rimosse. Questa precauzione assicura che il classificatore apprenda dal vero contenuto della pagina e non da indizi superficiali come parametri di tracciamento UTM, percorsi di rete o indirizzi CDN.
Successivamente, il testo normalizzato viene tradotto in inglese, memorizzando nei metadati la lingua originale rilevata. Questa standardizzazione linguistica consente al modello di deep learning di operare con elevata e uniforme precisione su domini internazionali in qualsiasi lingua. Conservare sia il testo originale sia la traduzione inglese garantisce la piena verificabilità durante le attività di conformità e audit.
Questa fase opera anche come un vero e proprio “quality gate”: il contenuto deve soddisfare precisi criteri di completezza e leggibilità, garantendo che l’AI elabori unicamente dati solidi e rappresentativi.
Protezione DNS di nuova generazione, interamente basata sul cloud e sull'intelligenza artificiale, facile da attivare.
Classificazione contestuale delle sequenze con DeBERTa-v3-base
Per la fase di classificazione FlashStart ricorre a DeBERTa-v3-base di FlashStart. Rispetto alle tradizionali architetture transformer, DeBERTa adotta un meccanismo di attenzione disaccoppiata (disentangled attention) che valuta separatamente il contenuto lessicale e la posizione relativa delle parole, cogliendo con estrema finezza le dipendenze sintattiche e semantiche della sequenza. Questa comprensione contestuale consente di discriminare con precisione sfumature complesse, distinguendo ad esempio un articolo divulgativo sulla sicurezza informatica da una minaccia di phishing attiva.
Prima dell’inferenza, il testo viene tokenizzato e troncato alla lunghezza di contesto supportata nativamente dal modello. L’algoritmo calcola quindi i punteggi di probabilità distribuendoli sulle 18 categorie della tassonomia adottata da FlashStart.
Ogni elaborazione restituisce una domain intelligence strutturata:
- Top Category: la categoria primaria con il punteggio di rilevanza più elevato.
- Confidence Score: un valore di confidenza relativo che riflette il livello di certezza del modello per la categoria principale.
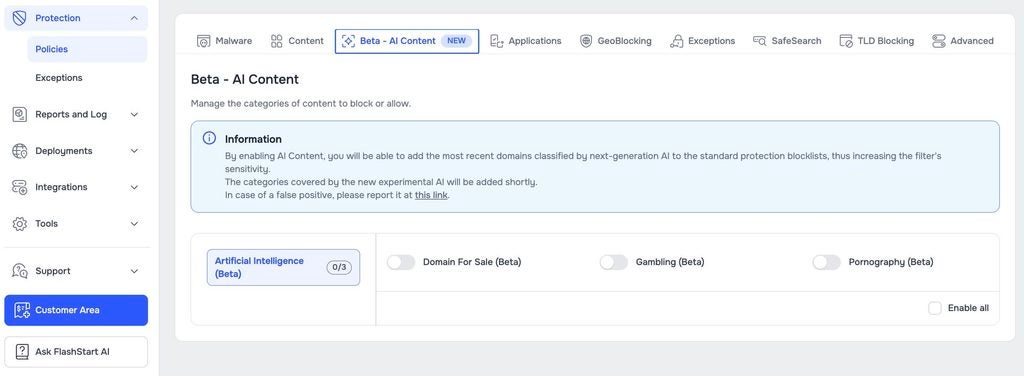
- Ranked Predictions: le tre categorie candidate più probabili restituite dal modello e ordinate per punteggio tra cui domainforsale, gambling e pornography, consentendo ai sistemi a valle di valutare tempestivamente eventuali casi di ambiguità.
- Inference Provenance: riferimenti di tracciabilità che collegano la classificazione finale all’esito del crawl, al testo tradotto e al timestamp esatto.
Intelligence operativa e innovazione continua
FlashStart mantiene una separazione netta tra classificazione AI ed enforcement delle policy: l’AI fornisce una ricca intelligence sui domini, mentre tu mantieni il pieno controllo sulle regole di filtraggio DNS applicate alla tua rete. I team di sicurezza possono stabilire soglie di confidenza personalizzate.
Per preservare l’accuratezza nel tempo rispetto all’evoluzione delle minacce web, FlashStart ottimizza costantemente i propri modelli AI tramite telemetria reale, set di validazione rappresentativi e pipeline di active learning.
Vuoi rafforzare la sicurezza DNS della tua organizzazione? Prova subito la nuova funzionalità di AI Domain Classification nella dashboard FlashStart e integra una protezione proattiva contro le minacce di nuova generazione. Per approfondire i dettagli di configurazione e integrazione, consulta la nostra documentazione ufficiale.
Protezione DNS di nuova generazione, interamente basata sul cloud e sull'intelligenza artificiale, facile da attivare.
Domande Frequenti (FAQ)
Qual è l’obiettivo dell’AI Domain Classification di FlashStart?
Il valore fondamentale del servizio risiede nell’incrementare la sensibilità e la reattività della protezione DNS: grazie all’AI di nuova generazione, i domini appena registrati o precedentemente sconosciuti vengono analizzati tempestivamente e classificati nelle tre seguenti categorie: Domain For Sale, Gambling e Pornography.
Questa funzionalità include direttamente il blocco a livello DNS?
No. La componente AI si occupa esclusivamente di classificazione e generazione di intelligence sul dominio, mentre il motore di FlashStart applica le regole di filtraggio, le soglie di confidenza e le autorizzazioni configurate dal team di sviluppo. La funzionalità può essere abilitata a discrezione dell’amministratore.
Il crawler effettua una scansione completa di tutte le pagine del sito?
No. Il crawler si limita ad acquisire la pagina della specifica URL richiesta, seguendo i redirect legittimi. Non naviga collegamenti esterni né pagine secondarie, mantenendo l’analisi estremamente rapida, efficiente e a basso impatto di risorse, risparmiando banda.
In che modo il sistema gestisce domini non raggiungibili o pagine vuote?
Se un dominio non dovesse restituire risposta (ad esempio per time-out del server), la pipeline archivia l’evento come esito operativo di crawl anziché attribuire una categoria forzata. Ciò garantisce l’accuratezza del modello ed evita falsi positivi su domini non attivi o parcheggiati.